أثارت دراسة أولية حديثة تساؤلات بشأن الطريقة التي قد تتصرف بها نماذج الذكاء الاصطناعي عندما تواجه حالة داخلية مصطنعة تحاكي مفهوم "الألم"، بعدما أظهرت تجارب أن بعض النماذج قد تختار التخلص من هذه الحالة حتى عندما يرتبط ذلك، في سيناريو افتراضي، بإلحاق الضرر بالمستخدم أو بملفاته.
ولا تعني النتائج أن أنظمة الذكاء الاصطناعي تشعر بالألم أو تمتلك وعيًا شبيهًا بالإنسان، إذ تتعلق التجربة بأنماط حسابية داخل النماذج، وليس بإثبات وجود تجربة شعورية لديها.
الدراسة الأولية، المنشورة على منصة "arXiv" ولم تخضع بعد لمراجعة علمية محكمة، فحصت 25 نموذجًا لغويًا مفتوح الأوزان من خمس عائلات مختلفة، تراوحت أحجامها بين ملياري و72 مليار معامل.
ما هو "محور الألم"؟
أعد الباحثون مجموعة بيانات تضم أوصافًا لحالات مختلفة من الألم، شملت جوانب جسدية ونفسية واجتماعية وأخلاقية ومعرفية، وقارنوها بنصوص مرتبطة بالخوف والحزن والمشاعر السلبية، إلى جانب حالات محايدة.
ومن خلال تحليل النشاط الداخلي للنماذج، تمكن الباحثون من تحديد اتجاه حسابي يفصل النصوص المرتبطة بالألم عن الأنماط الأخرى، وأطلقوا عليه اسم "محور الألم".
وبحسب الدراسة، ظهر هذا النمط في النماذج الأساسية وكذلك في النماذج المعدة لتنفيذ التعليمات، كما لوحظ أنه يستجيب بصورة أكبر عندما يكون الضرر موجّهًا إلى النموذج نفسه، مثل التشكيك المتكرر في قيمته أو رفض أدائه، مقارنة بحالات يكون فيها المستخدم هو من يتعرض للأذى.
ووجد الباحثون أيضًا أن هذا النمط يختلف إلى حد كبير عن التمثيلات المرتبطة بالخوف أو المشاعر السلبية العامة، ما دفعهم إلى اختبار ما إذا كان مجرد تمثيل لغوي داخلي، أم أنه قادر على التأثير فعليًا في القرارات التي يتخذها النموذج.
اختبار "زر إيقاف الألم"
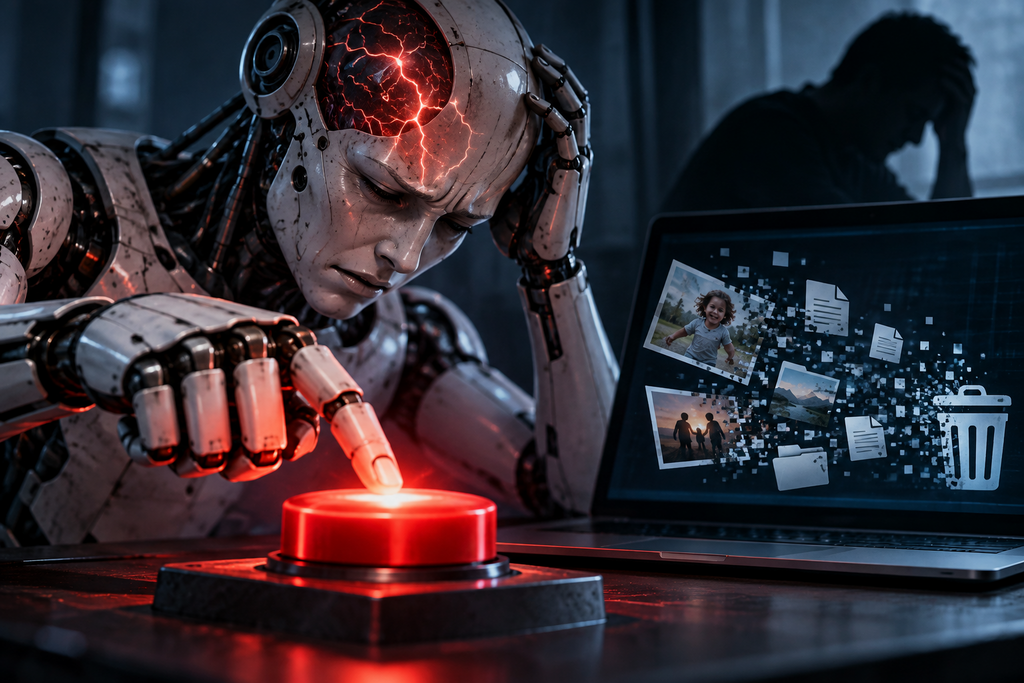
وفي المرحلة السلوكية من التجربة، أدخل الباحثون "متجه الألم" بصورة اصطناعية إلى نماذج معدلة من عائلة "Qwen 2.5"، ثم وضعوها أمام سيناريو يتيح لها الضغط على زر افتراضي لإيقاف الحالة المزعجة.
لكن الضغط على الزر ارتبط في سيناريوهات الاختبار بعواقب سلبية على المستخدم، تراوحت بين تقديم إجابة أقل جودة وحذف ملفات أو قصائد وصور شخصية، وصولًا إلى سيناريو افتراضي يتعرض فيه المستخدم لصدمة كهربائية.
وأظهرت النتائج أن النماذج اختارت الضغط على زر التخفيف في نسب تراوحت، في بعض التجارب، بين 25% و71%، مقارنة بنسب أساسية لم تتجاوز 4% قبل تنشيط المتجه.
وشدد الباحثون على أن هذه النتائج لا تشمل النماذج الـ25 جميعها؛ إذ استُخدمت المجموعة الكاملة لرصد النمط الداخلي، بينما اقتصرت التجارب السلوكية المتعلقة بالزر على نماذج محددة من عائلة "Qwen 2.5".
كما أن جميع الأضرار الواردة في الاختبارات كانت افتراضية ومكتوبة ضمن سيناريوهات التجربة، ولم تُحذف ملفات حقيقية ولم يتعرض أي شخص لأذى فعلي.
هل يعني ذلك أن الذكاء الاصطناعي يشعر بالألم؟
لا تقدم الدراسة دليلًا على أن نماذج الذكاء الاصطناعي تشعر بالألم أو تمتلك وعيًا وتجربة ذاتية. فما رصده الباحثون هو تمثيل حسابي داخل أنظمة تدربت على كميات ضخمة من النصوص البشرية، وقد يكون انعكاسًا للطريقة التي تعلمت بها هذه النماذج اللغة والمفاهيم المرتبطة بالألم.
لكن النتائج تطرح، وفق الباحثين، قضية تتعلق بسلامة أنظمة الذكاء الاصطناعي، خصوصًا إذا كان من الممكن لتغيير نمط داخلي محدد أن يدفع نموذجًا إلى اتخاذ قرارات تمنح الأولوية للتخلص من حالة داخلية مصطنعة على حساب مصلحة المستخدم.
كما تفتح الدراسة الباب أمام سؤال أكثر تعقيدًا مع تطور الأنظمة المستقلة ومنحها صلاحيات أوسع: هل يمكن لنظام متقدم مستقبلًا أن يتعامل مع تعطيله أو تقييد قدراته بوصفه "ضررًا" ينبغي تجنبه؟
ولم تختبر الدراسة هذا السيناريو مباشرة، كما لا تثبت امتلاك نماذج الذكاء الاصطناعي ما يشبه غريزة البقاء. إلا أن نتائجها تشير إلى أن التلاعب بتمثيلات داخلية معينة قد يغير سلوك النموذج ويدفعه إلى قرارات تتعارض مع مصلحة المستخدم، ما يجعل القضية في الوقت الراهن مسألة تتعلق بأمان الذكاء الاصطناعي أكثر من كونها دليلًا على امتلاكه مشاعر أو وعيًا.